
Veri Kaybını Önleme (Data Loss Prevention – DLP) çözümleri, kurumların hassas verilerinin yetkisiz kişilerle paylaşılmasını, kurum dışına çıkarılmasını veya kontrolsüz biçimde kullanılmasını engellemek amacıyla kritik bir güvenlik katmanı oluşturmaktadır. Ancak bir DLP ürününün “dosyayı tarıyor olması”, dosyanın içeriğinin tamamını mutlaka analiz ettiği anlamına gelmemektedir. DLP sistemlerinde en az üç farklı sınırın birbirinden ayrılması gerekmektedir: dosyanın sisteme kabul edilebileceği maksimum boyut, dosyadan çıkarılabilecek ve analiz edilebilecek içerik miktarı ve analiz motorunun bu işlem için kullanabileceği maksimum süre. Ancak burada kritik olan standart tarama boyutunun kurumsal trafikte dolanan ortalama dosya boyutlarının çok altında kalıyor olmasıdır.
DLP mimarilerinde gözden kaçabilen önemli bir ayrıntı bulunmaktadır. Dosyanın fiziksel boyutu ile DLP motorunun analiz ettiği içerik miktarı aynı şey değildir. Dosya boyutu 10 GB olabilir fakat DLP motoru bu dosyadan yalnızca belirli miktarda metin çıkarıp analiz ediyor olabilir. Standart olarak belirlenen bu belirli miktarlar, üreticilerin önceden belirlemiş olduğu tavan değerlere yükseltilebilir. Üretici dokümantasyonları da büyük dosya limitlerinin artırılmasının doğrudan bellek tüketimini ve işlem yükünü artırdığını açıkça belirtmektedir. Dosyanın kendisi 20 MB olabilir. Fakat dosyadan çıkarılan metin 40 MB’a ulaşabilir. DLP ürünü fiziksel olarak 20 MB’lık dosyayı kabul etse bile, içerik çıkarma motoru yalnızca belirli miktardaki metni sınıflandırma motoruna aktarabilmektedir.
Bu durum bir ürün hatası veya üreticinin gizlediği bir açık değildir ve DLP atlatma yöntemi olarak değerlendirilmemelidir. Aksine, pek çok kurumsal DLP platformunun resmi dokümantasyonunda performans, bellek kullanımı, analiz süresi ve ölçeklenebilirlik nedeniyle açıkça tanımlanmış bir tasarım sınırı olarak yer almaktadır. Çünkü ortada çoğu durumda beklenmeyen bir davranış yoktur. Asıl problem, bu sınırların kurum ya da kişiler tarafından bilinmemesi veya güvenlik mimarisinde dikkate alınmamasıdır. Dolayısıyla bu limitler çoğu zaman bir güvenlik açığından ziyade kaynak yönetimi ile güvenlik kapsamı arasındaki mühendislik tercihi olarak düşünülmelidir.
Gartner raporlarına göre en yüksek kullanım oranına sahip DLP ürünlerinden birinde “Extracted Text Size Per File” değerini 1 MB olarak tanımlamaktadır. Aynı dokümantasyon, dosya boyutunun bundan çok daha yüksek olabileceğini de göstermektedir. Bu durumda 100 bin satırlık bir Excell formatındaki dosya Discovery modunda dahi çalıştırıldığında, yaklaşık olarak 4000 satırın taranıp geri kalan satırlara bakılmaksızın sonuç getirileceği anlamına gelmektedir.
Ek olarak üreticilerin belirlediği standart analiz süreleri de bu aşamada oldukça önemlidir. Ajan, işlemi analiz motoruna gönderdiğinde işlem türüne bağlı olarak sistem tarafından standart bir analiz süresi verilmektedir. Belirlenen süre DLP motorunun politika analizi için sahip olduğu zaman bütçesidir. Süre dolduğunda motor, o ana kadar gerçekleştirebildiği analiz üzerinden bir sonuç döndürmektedir. Bu süre sonunda policy engine elindeki en iyi sonucu döndürür ve nihai aksiyon partial analysis temelinde oluşturulmaktadır.
Örneğin bir PDF dosyasında hassas bilgi doğrudan ham dosya içerisinde, sıkıştırılmış bir Office dosyasının içerisinde veya görüntü olarak bulunabilir. DLP motorunun öncelikle bu içeriği analiz edilebilir bir forma dönüştürmesi gerekmektedir. Örneğin 2 MB’lık basit bir TXT dosyasının analiz edilmesiyle ilk 1MB taramaya alınabilir ve TXT içeriğine bağlı olarak analiz süre limitine de takılabilmektedir. Tüm bunların dışında 500KB bir dosyanın karmaşık PDF, çok sayıda embedded object içeren DOCX, iç içe yapıya sahip Office dosyası, OCR gerektiren belge, çok sayıda regex’e maruz kalan içerik ve benzeri durumlarda olması da DLP tarafından analiz süresi sebebiyle tamamen verimli taranacağı anlamına gelmemektedir.
Çünkü DLP motoru yalnızca bir dosyayı okumaz. Aynı anda:
- Dosya formatını analiz eder.
- İçeriği çıkarır.
- Arşivleri açabilir.
- İç içe dosyaları işler.
- OCR çalıştırabilir.
- Metni normalize eder.
- Regex çalıştırır.
- Sözlük eşleştirmeleri gerçekleştirir.
- Fingerprint/EDM kontrolleri yapabilir.
- Makine öğrenmesi modellerini çalıştırabilir.
- Politika değerlendirmesi gerçekleştirebilir.
- Sonuçları incident sistemine aktarabilir.
Bunların tamamı CPU, RAM, DISK ve ZAMAN tüketmektedir.
Özellikle Network DLP sistemlerinde aynı anda yüzlerce veya binlerce işlemin gerçekleşebildiği düşünüldüğünde, teorik olarak sınırsız içerik analizi yapmak pratik değildir. Ancak spesifik bir dosyanın taranması istenildiğinde, bu dosyanın tamamının taranamıyor ve sonuç sunulamıyor olması da kurumlar için büyük bir açık yaratmaktadır.
DLP üzerinde bir dosyayla karşılaşıldığında, dosyanın yalnızca uzantısına bakarak içerik analizi gerçekleştirilmemektedir. Öncelikle dosyanın türünü ve yapısını belirlenemkte; ardından desteklenen bir dosya formatıysa içeriği analiz edilebilir bir forma dönüştürülmektedir. Bu aşamada PDF, Office belgeleri, e-posta dosyaları, arşivler veya görseller gibi farklı formatlardan metin ve gerektiğinde diğer içerik bileşenleri çıkarılabilir. Görüntü tabanlı belgelerde ise OCR (Optical Character Recognition) kullanılarak görsel içerisindeki yazılar metinsel içeriğe dönüştürülebilmektedir. Elde edilen içerik daha sonra normalizasyon ve ilgili içerik işleme adımlarından geçirilerek DLP’nin hassas veri tespiti gerçekleştiren motorlarına aktarılmaktadır. Bu aşamada regex tabanlı kurallar, sözlükler, fingerprinting/EDM gibi veri eşleştirme yöntemleri veya makine öğrenmesi tabanlı sınıflandırıcılar kullanılabilir. Son aşamada elde edilen analiz sonucu kurumun DLP politikalarıyla karşılaştırılır ve dosyanın engellenmesi, karantinaya alınması, izlenmesi veya izin verilmesi gibi bir politika kararı verilmektedir.
ZIP, RAR, TAR ve benzeri sıkıştırılmış dosya formatları DLP açısından ayrı bir problem unsuru kabul edilmektedir. DLP motorunun aşağıdaki aşamaları adım adım gerçekleştirebilmesi gerekmektedir. Bazı ürünlerde örneğin toplam çıkarılan alt dosya boyutu 50 MB ve alt dosya sayısı 100 ile sınırlandırılabilirken, ayrıca dosya başına çıkarılmış metin sınırı da bulunabilmektedir.
- Arşivi açabilmesi,
- İçindeki dosyaları çıkarabilmesi,
- İç içe arşivleri desteklemesi,
- Belirli sayıda alt dosyayı işleyebilmesi,
- Toplam çıkarılan veri miktarını yönetebilmesi,
- Her alt dosyanın içeriğini analiz edebilmesi
Bu sebeple DLP testleri yalnızca “hassas veri var/yok” şeklinde yapılmamalıdır. “Bir dosyaya kredi kartı numarası koyduk, DLP yakaladı.” şeklinde yapılan testlerden doğru sonucun alınamayacağı beklenen bir senaryodur.
Aşağıda DLP üreticileri içerisinden en yaygın olanları için kendi web siteleri üzerinden alınan tarama boyutları ve analiz sürelerini içeren dokümanlara ait ekran görüntüleri, kaynakçaları dahil edilerek eklenmiştir.
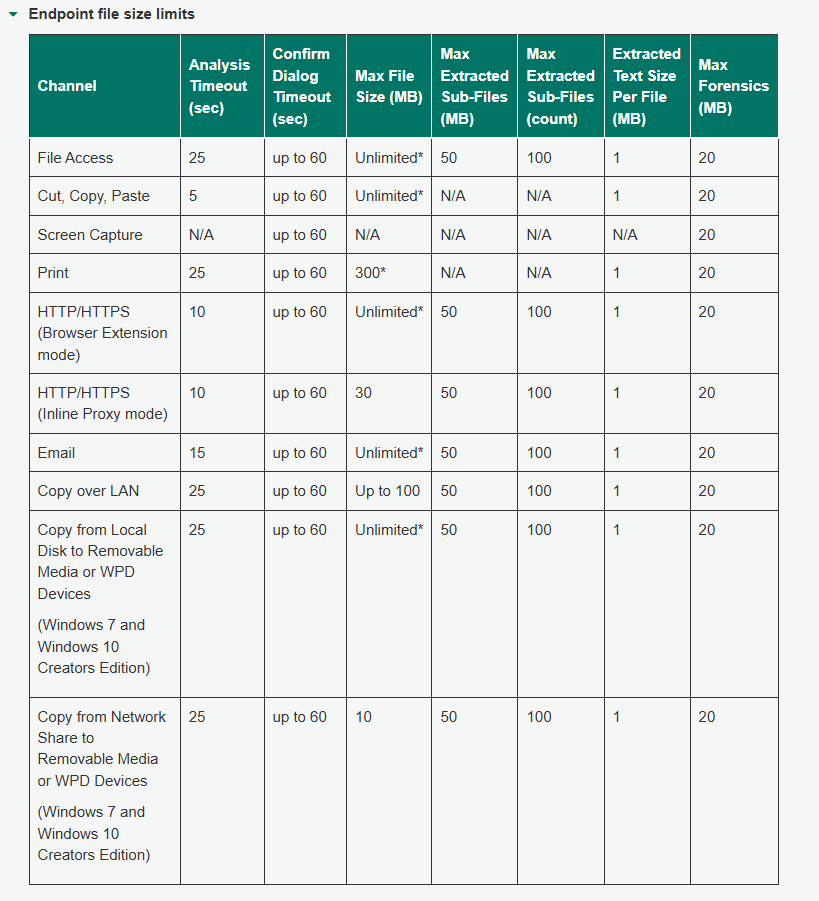
Forcepoint DLP için tarancak olan dosyanın boyutu çoğu zaman Unlimited olarak belirlenmişken, ilgili dosyadan çıkarıp analiz motoruna verebildiği metinsel içerik miktarı standartta 1MB olarak belirlenmiştir. Dosyadan DLP’nin çıkarabildiği metnin dosya başına sadece 1 MB’lık kısmı analiz kapsamına alınmaktadır. Ek olarak 100 MB’ın üzerindeki dosyalarda sistem içerik extraction yapmamaktadır. Sadece dosya adı, dosya boyutu ve binary fingerprint gibi bilgileri kullanmaktadır. Binary fingerprint ise dosyanın başından ve sonundan alınan 5’er MB örneklemler üzerinden oluşturulmakta ve tam eşleşme gerektirmektedir. Bu limit arşivlenmiş dosya içerisindeki her dosya/sub-file için uygulanmaktadır. Forcepoint ayrıca arşivlerden çıkarılabilecek toplam veriyi 50 MB ve alt dosya sayısını 100 ile sınırlandırmaktadır.
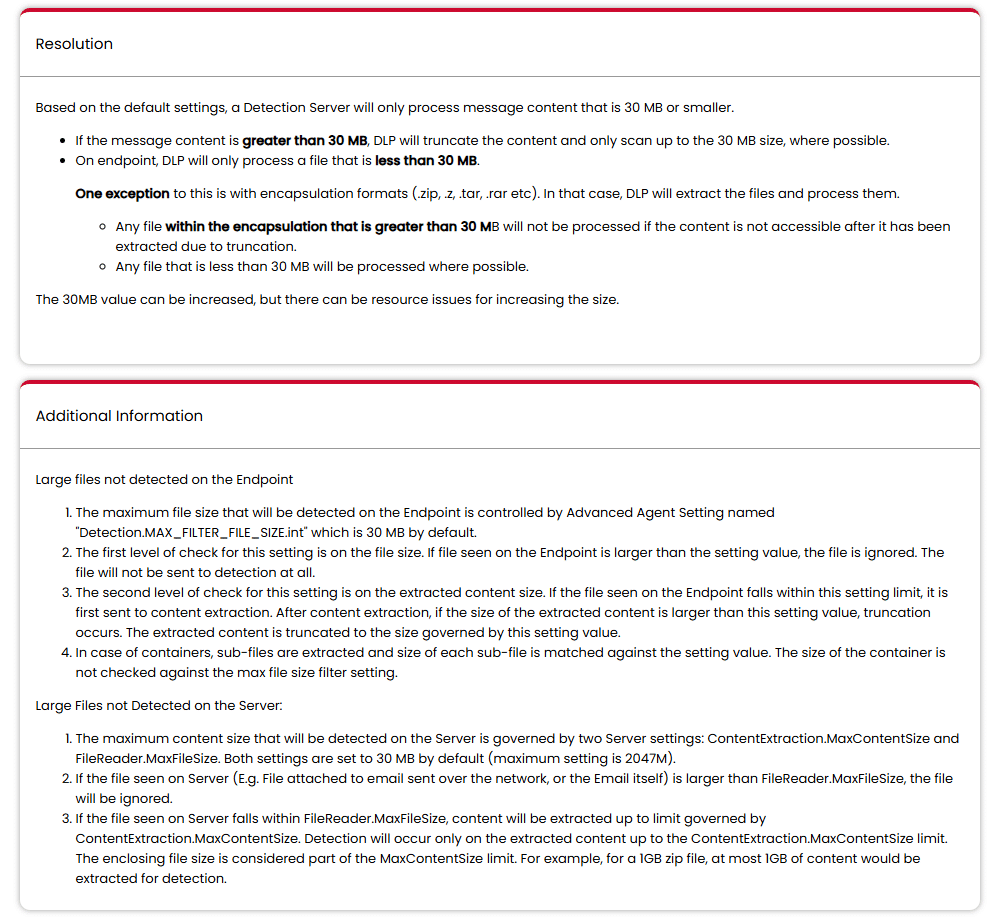
Broadcom’un Data Loss Prevention dokümantasyonunda varsayılan 30 MB dosya işleme limiti bulunmakta; ancak ürün burada da dosya boyutu ile çıkarılmış içerik boyutunu ayrı aşamalarda değerlendirmektedir. Endpoint tarafında dosya boyutu ilk kontrolde 30 MB’ı aşıyorsa dosya detection’a gönderilmez. Dosya bu sınırın içerisindeyse content extraction gerçekleştirilir ve çıkarılan içeriğin boyutu ayrıca kontrol edilir; bu içerik sınırı aşarsa extraction sonucu truncate edilir. Yani dosyanın fiziksel boyutu kontrol edilir ve eğer 30 MB’tan büyükse dosya ignore edilmektedir ve detection’a hiç gönderilmemektedir. Eğer 30 MB’ın altındaysa content extraction yapılmaktadır, extraction sonrasında elde edilen içerik 30 MB’tan büyükse içerik 30 MB’a truncate edilmektedir. Server tarafında ise FileReader.MaxFileSize ve ContentExtraction.MaxContentSize adlı iki ayrı parametre kullanılmaktadır. Her iki parametrenin varsayılanı 30 MB olup dokümantasyonda 2047 MB’a kadar desteklenebildiği belirtilmektedir.
Bu nedenle bir DLP çözümünün gerçek analiz kapsamını değerlendirirken yalnızca “maksimum dosya boyutu nedir?” sorusu yeterli değildir. Ayrıca “çıkarılabilir içerik limiti nedir?”, “analiz için tanımlanan zaman aşımı nedir?” ve daha önemlisi “analiz bu sınırların herhangi birine ulaştığında sistem hangi kararı vermektedir?” soruları da mutlaka cevaplanmalıdır.
